活动海报
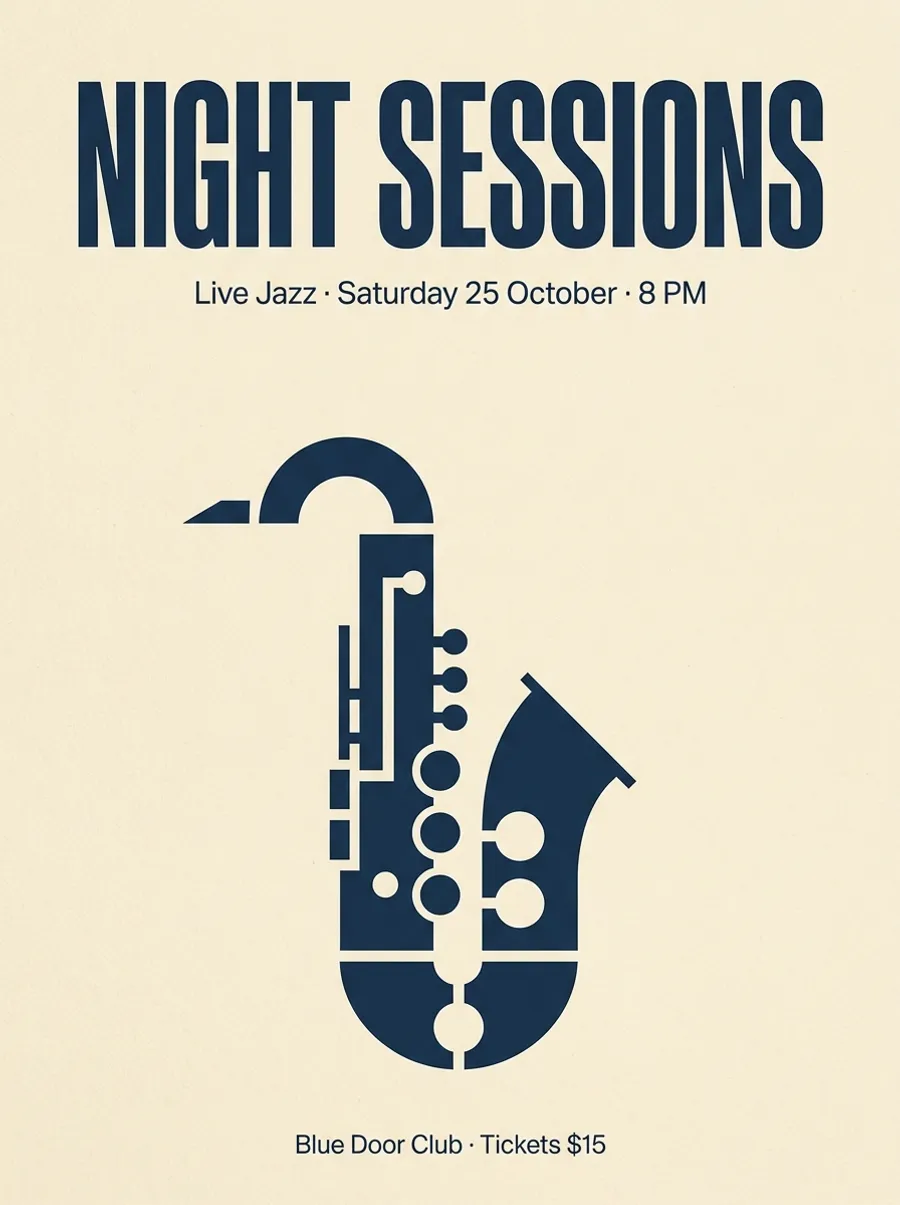
标题、副标题和日期行。
基于开源 MOSS Image 模型,一键生成海报、信息图、产品标签和社媒配图,中英文文字准确可读、不乱码。生成器目前为预览版,新账户即送免费积分。
生成结果
生成的图片会显示在这里。输入提示词或绘制布局,然后点击生成。
点击“试试这个提示词”,把示例加载到生成器里,再换成你自己的文字。
标题、副标题和日期行。
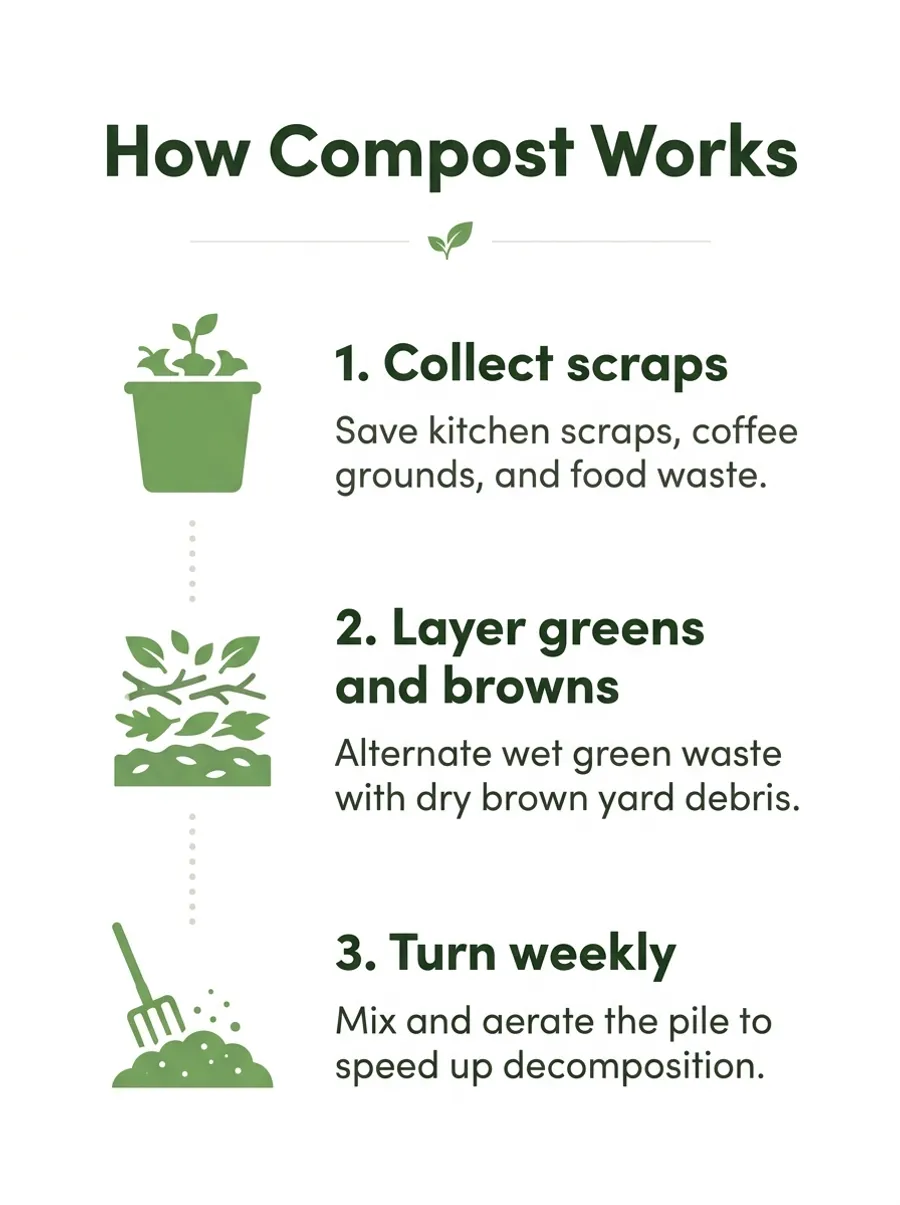
三个编号步骤。
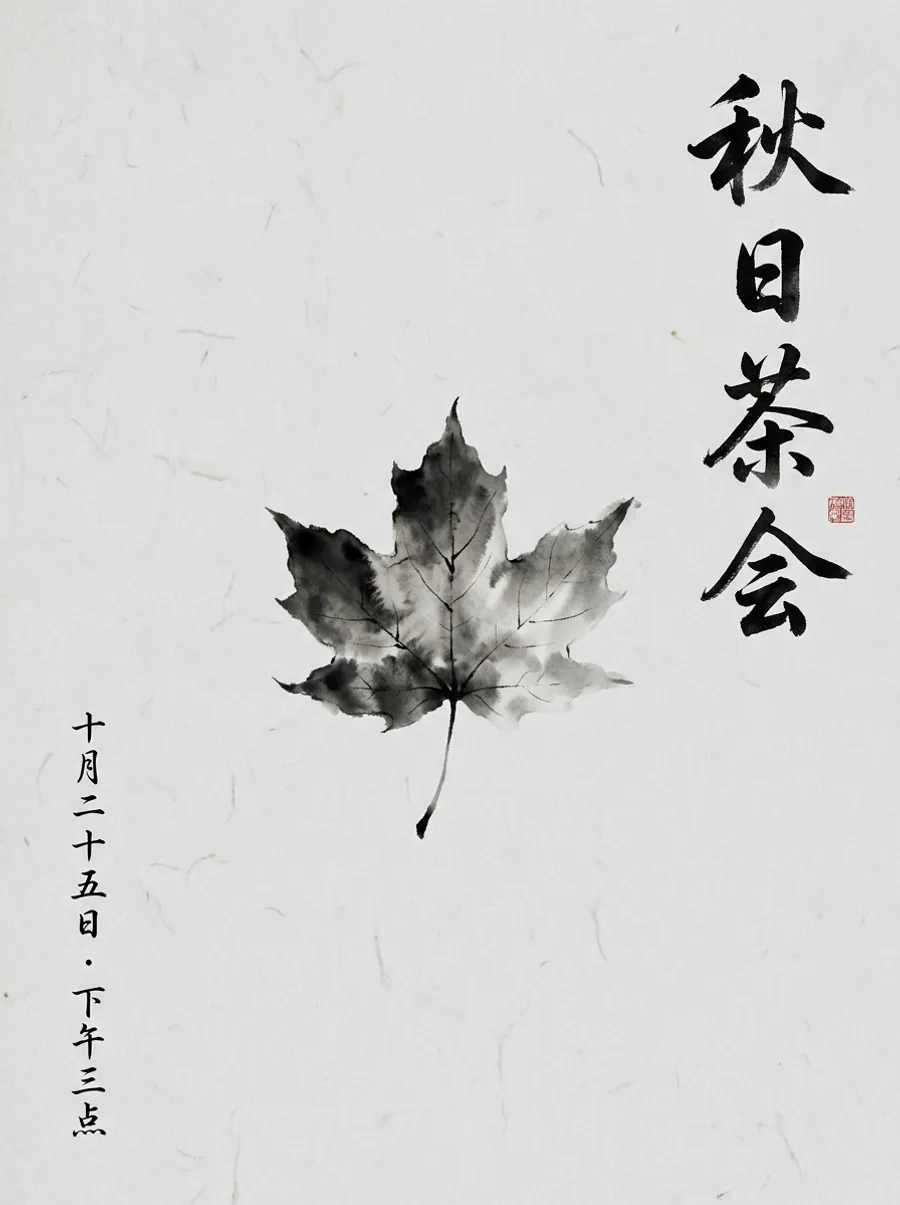
竖排水墨标题。
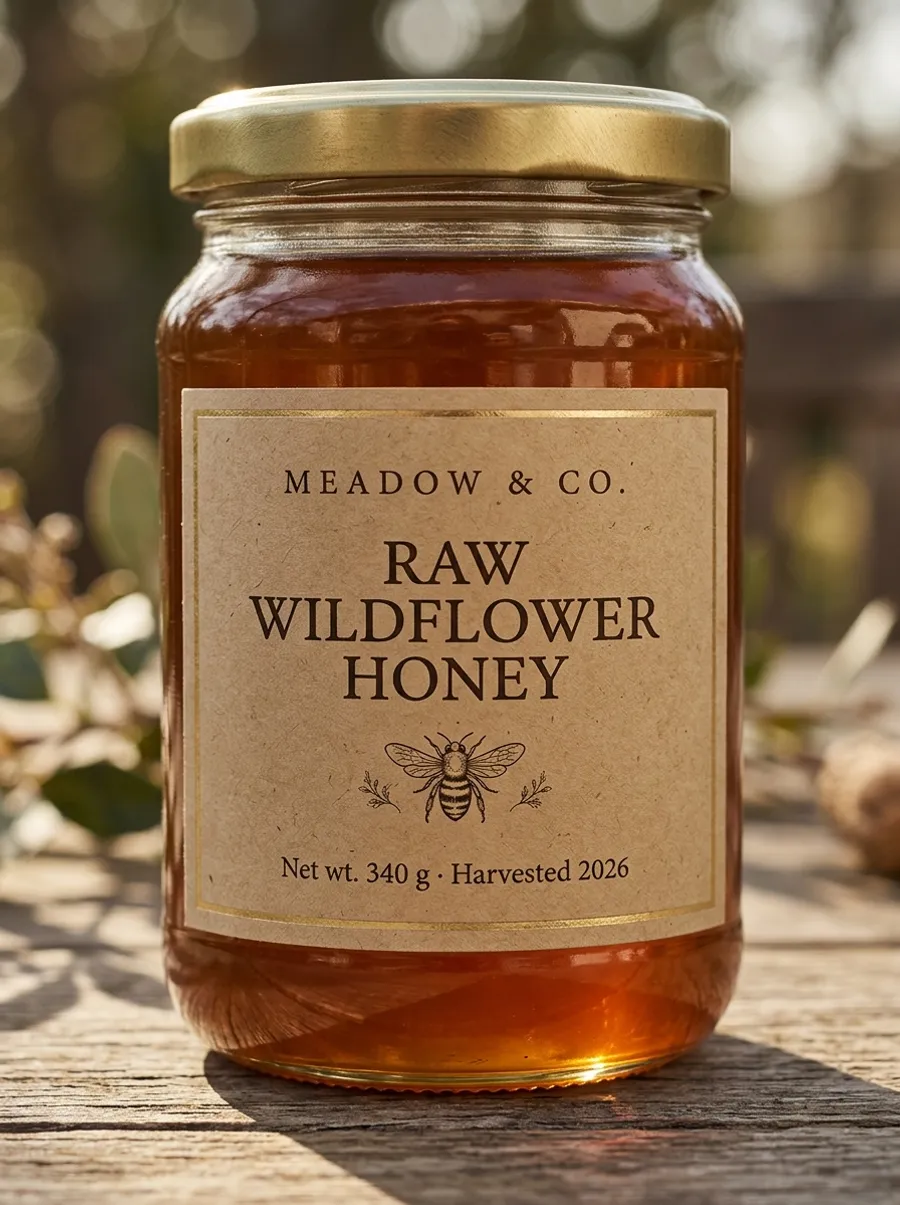
品牌、品名和净含量。
两行语录加署名。
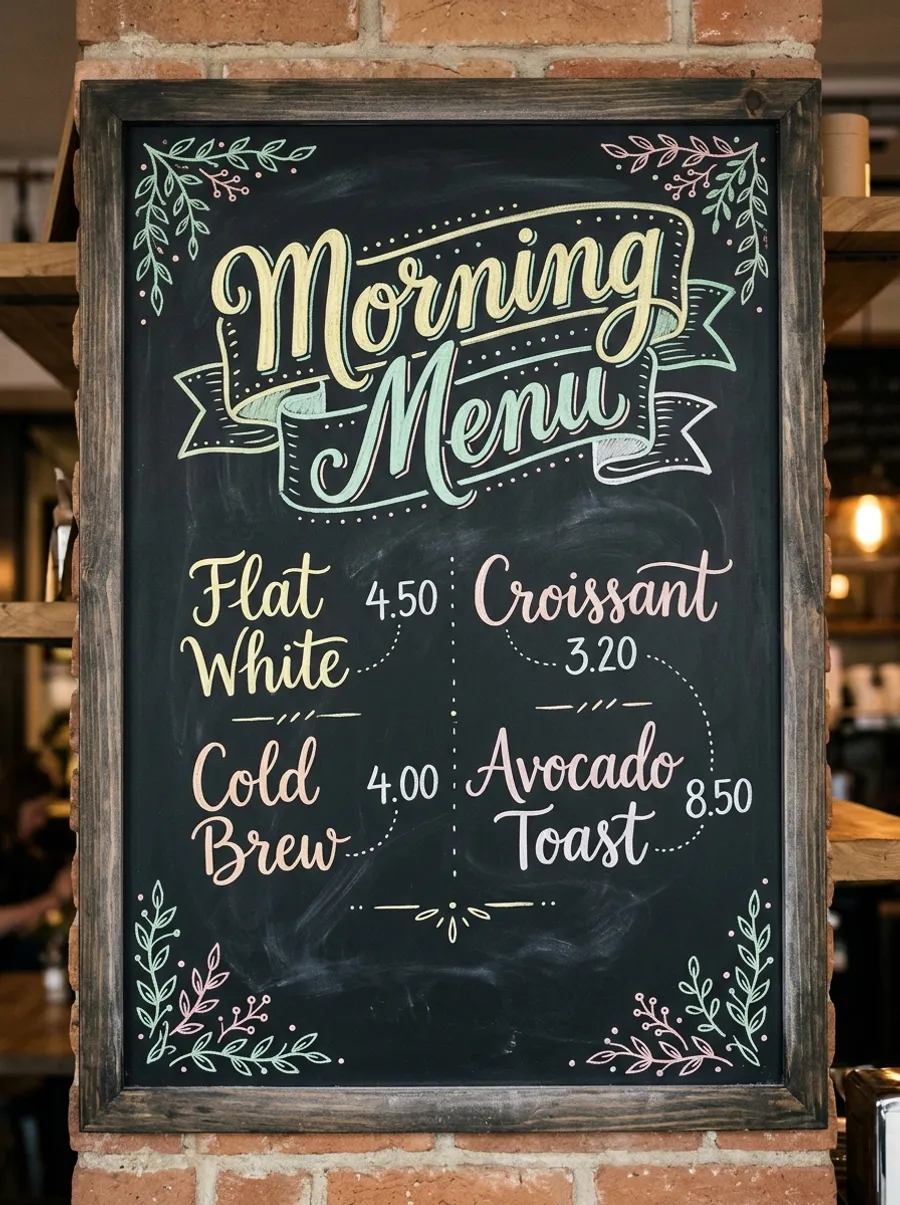
两列品名与价格。
OpenMOSS 推出的 50 亿参数开源模型,专为文字渲染而生,而非追求照片级写实。
在目标文本平均 1,340 字符的 LongLongTextBench 上,MOSS Image 得分 96.3,Qwen Image 2512 为 64.9。
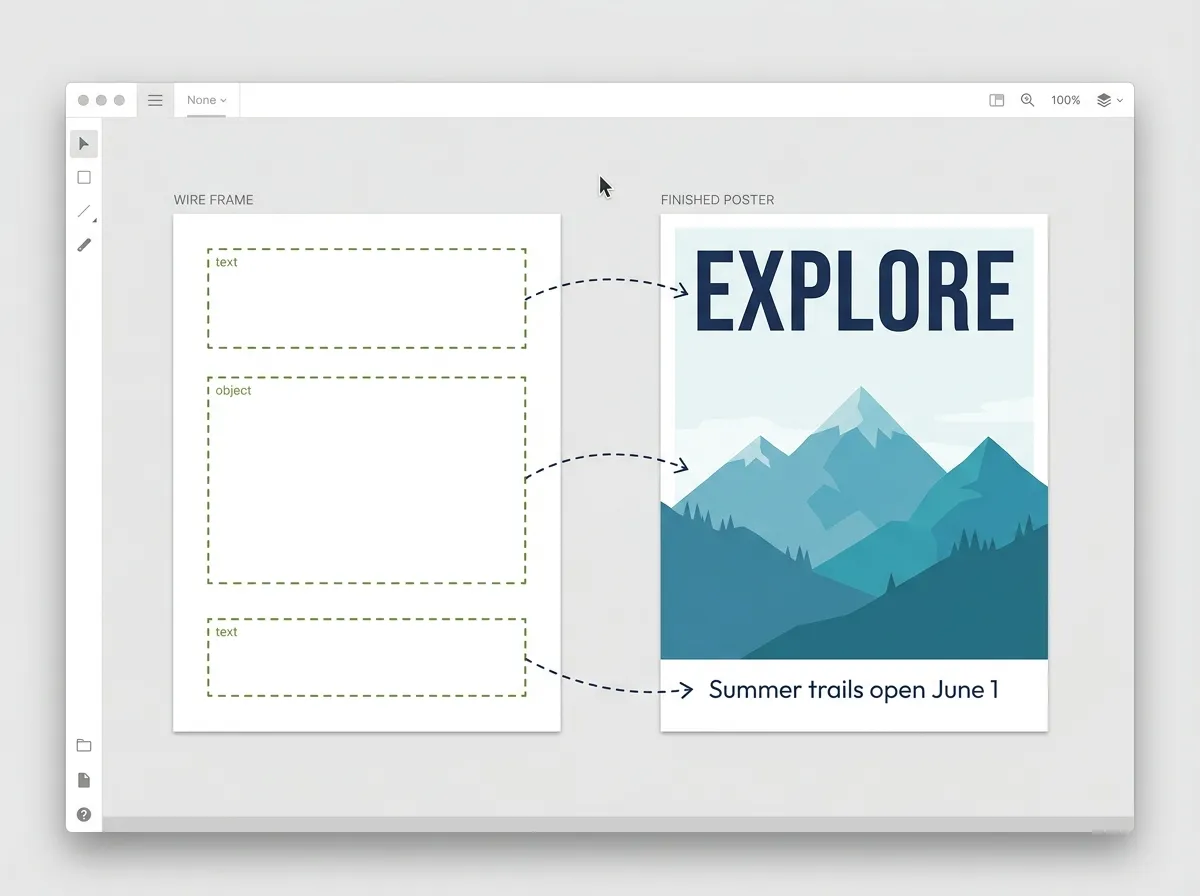
MOSS Image 的版式 JSON 在 7Bench 上取得 0.88 mIoU,Ideogram 4 为 0.44。
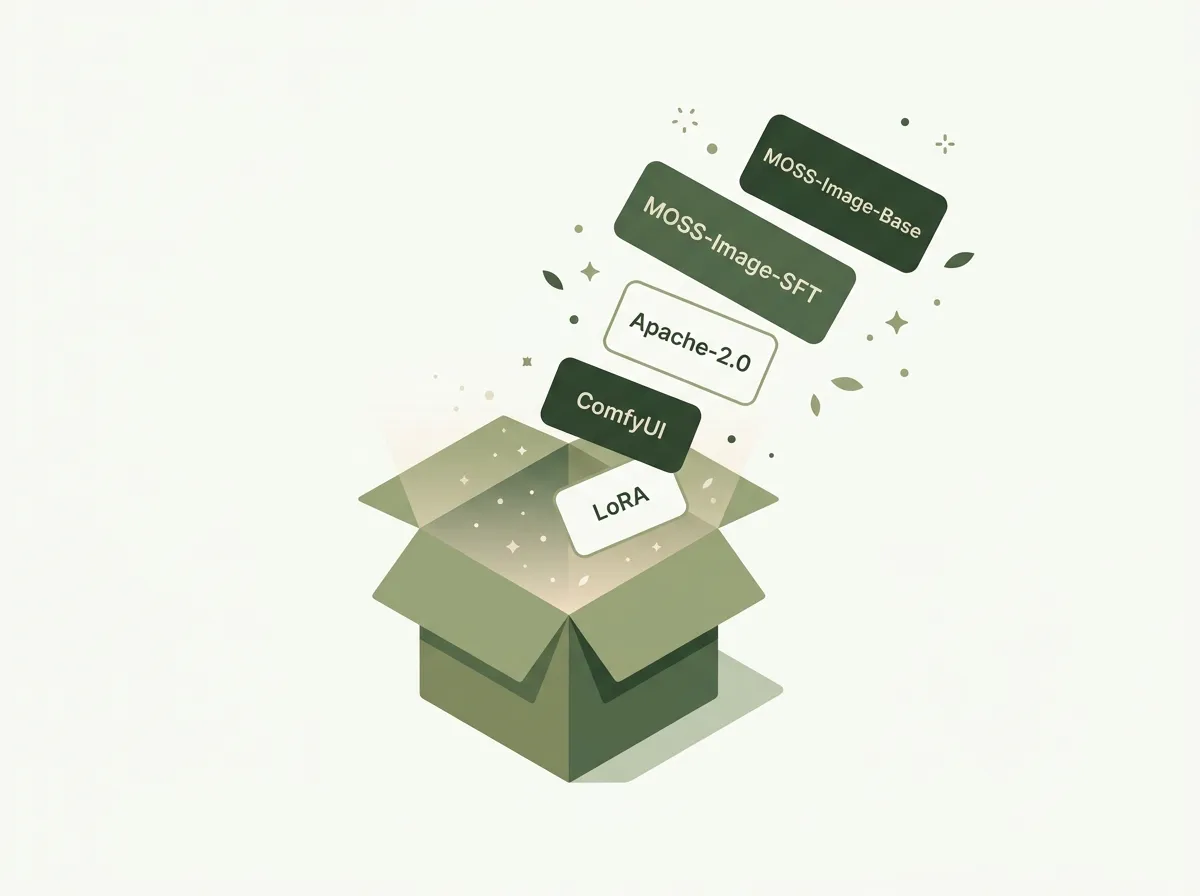
Apache-2.0 开源权重,ComfyUI 首日支持,发布四天内社区已有 30 多个 LoRA。
你写文字,MOSS Image 生成器负责排版。
标题、副标题、日期。换行决定每行在哪里结束。
海报选 2:3,社媒选 1:1,封面选 16:9。最高 2K。
哪个字不对,改一下再跑一次。生成失败会退还积分。
文字和画面同样重要的地方。
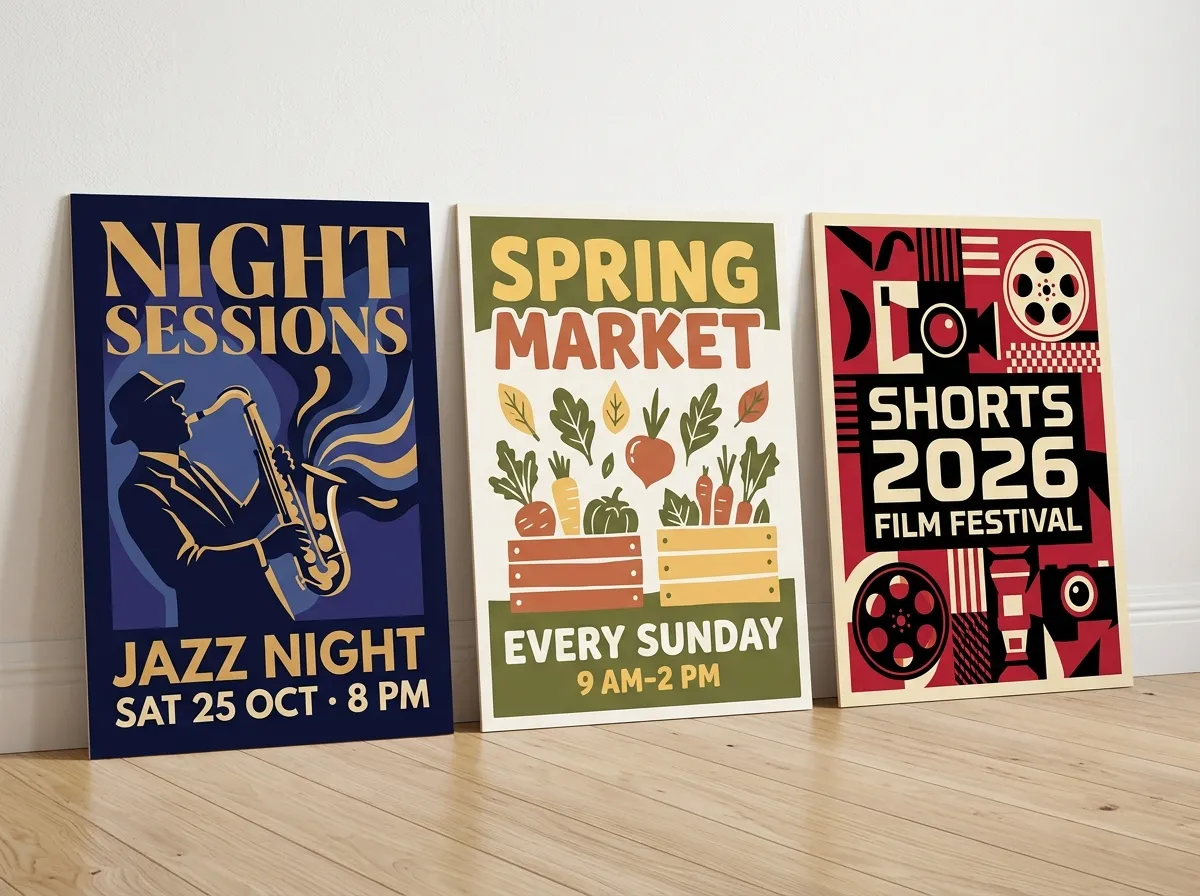
标题、详情和行动号召,每个字都清晰。
编号步骤和带标注的图解。
语录卡片和公告图,文案直接生成在图上。
大标题的视频封面和电子书封面。
海报、公众号封面和电商主图,汉字笔画完整。
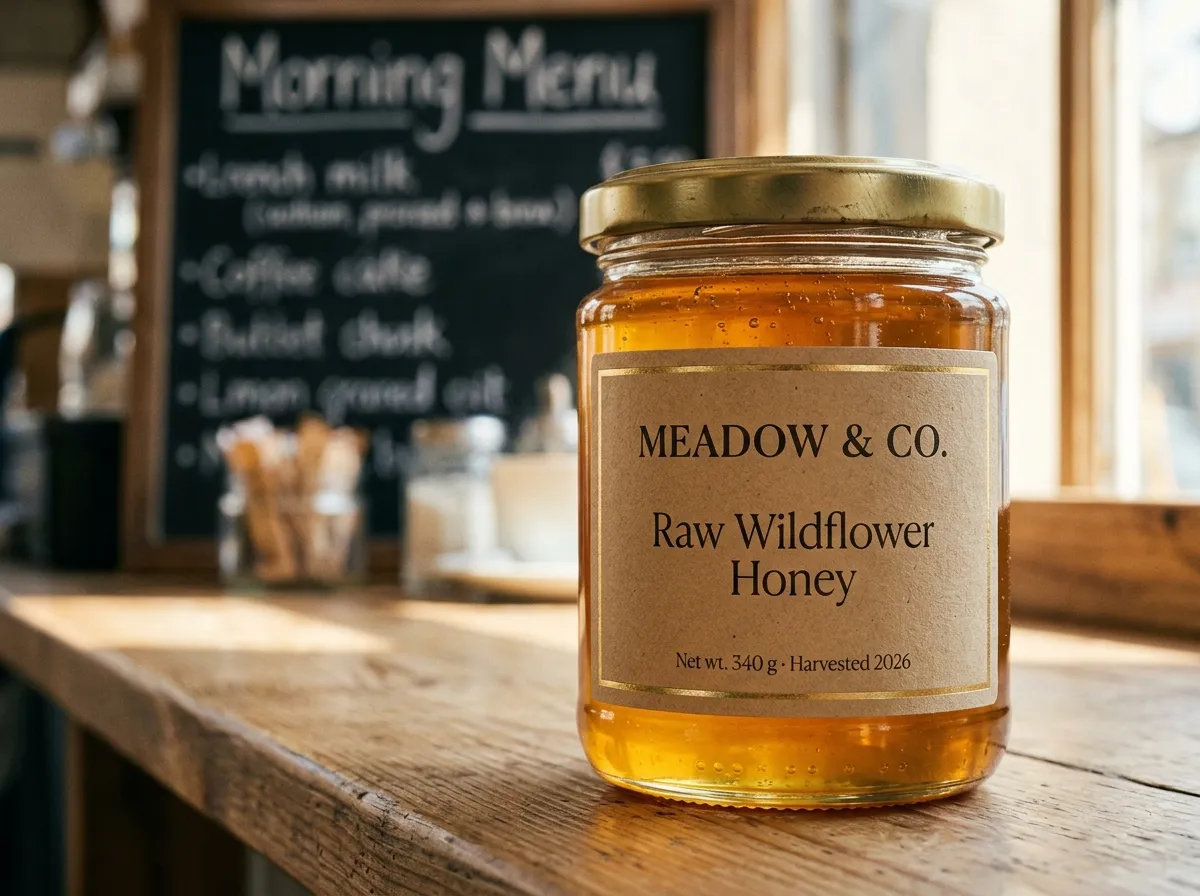
品名和价格必须一字不差的地方。
专为承载文字的图片而打造。
中英文文字怎么写就怎么出。
拖画文本框,导出 MOSS Image 版式 JSON。
约半分钟出一张成品图。
七种画幅比例,1K 或 2K。
提示词和指南都有中英文版本。
每张图都保存在你的账户里。
这个模型是什么、为什么出现,以及 MossImage 如何在它之上构建。
MOSS Image(官方写法为 MOSS-Image)是 OpenMOSS 于 2026 年 10 月 16 日以 Apache-2.0 许可证发布的开源文生图模型。它采用单流扩散 Transformer 架构,参数量 50 亿,搭配 Qwen3.5-9B 文本编码器和 FLUX.2 VAE,训练数据约 30 亿张图片。它的目标不是在照片级写实上取胜。它的使命是做好两件大多数生成器都做不好的事:正确渲染大段中英文文字,并把元素放到你指定的位置。
扩散模型从图片描述中学习,而描述很少逐字写出招牌上的每个词。模型学会的是文字“长什么样”,而不是“写了什么”,于是生成出形似字母的噪点、漏字,或者把你的标题改写一番。每多一行,就多一次出错的机会。中文受害最深:训练描述绝大多数是英文,大多数模型从未学会汉字是怎么构成的。
技术报告(arXiv 2610.23374)提出了 LongLongTextBench:240 条提示词,中英文各半,目标文本平均约 1,340 个字符。MOSS Image 平均得分 96.3,长英文 97.1,长中文 92.4。Qwen Image 2512 为 64.9,Ideogram 4 为 63.5。提示词窗口为 4,096 个 token,提示词里的换行会直接变成图片里的换行,段落在哪里折行由你决定。
你可以不写“标题在顶部,logo 在左下角”这样的描述,而是直接给模型一个 JSON 对象。每个元素包含一个标签(text、character 或 object)、一段说明、可选的文本字符串,以及一个以画布中心为原点、用绝对像素坐标表示的边界框。在 7Bench 版式基准上,这种方式取得 0.88 的平均 IoU,Ideogram 4 为 0.44,GPT Image 2、Nano Banana Pro 和 Seedream 5.0 Pro 为 0.14 到 0.17。人工评测中,JSON 提示词也比详细的文字描述更受青睐,Elo 分数 1,622.87 对 1,509.21。该功能目前标记为实验性,格式详见我们的 MOSS Image 版式 JSON 指南。
所有需要在图片里放文字的人:制作海报的活动主办方、产出信息图和语录卡片的营销人员、需要一张产品标签的小品牌,以及中英文双语协作的团队。ComfyUI、Diffusers、SGLang 和 vLLM-Omni 在发布首日就支持了这个模型,社区在四天内发布了 30 多个 LoRA、微调版本和量化权重。
更多示例(包括中文示例)见 MOSS Image 提示词库。
MossImage 是围绕该模型搭建的独立生成器和知识库,与 OpenMOSS 无隶属关系。该模型目前还没有官方托管 API,所以我们的在线生成器在引擎集成完成前处于预览阶段,每张结果都会标明由哪个引擎生成。版式模式(拖画文本框并导出版式 JSON,无需手动输入坐标)正在开发中。MOSS Image 模型指南涵盖了模型架构、推荐参数(50 步以上、CFG 3、shift 5)以及如何自己运行权重。
该模型目前只支持文生图,参考图和图片编辑列为后续工作。长中文文本略逊于英文,92.4 对 97.1。论文中效果最好的版式依赖外部语言模型来扩写提示词,版式 JSON 也仍处于实验阶段。它需要 50 步以上的采样,速度并不快,作者也坦言这个模型的卖点是文字和结构,而不是纯粹的写实感。每次生成都请校对一遍,文字渲染在不同批次间会有差异。
来自 MOSS Image 用户指南和我们的实测。
标题“夏日特卖”,副标题“全场八折一整周”。
“标题在顶部,日期在左下角。”
繁杂的场景会和文字抢注意力。
比例和内容打架时,文字折行会很难看。
把汉字写进提示词,而不是用英文描述。
留下每个字都正确的那一版。
关于模型和本站。
还有疑问?联系我们,或阅读 MOSS Image 模型指南。